




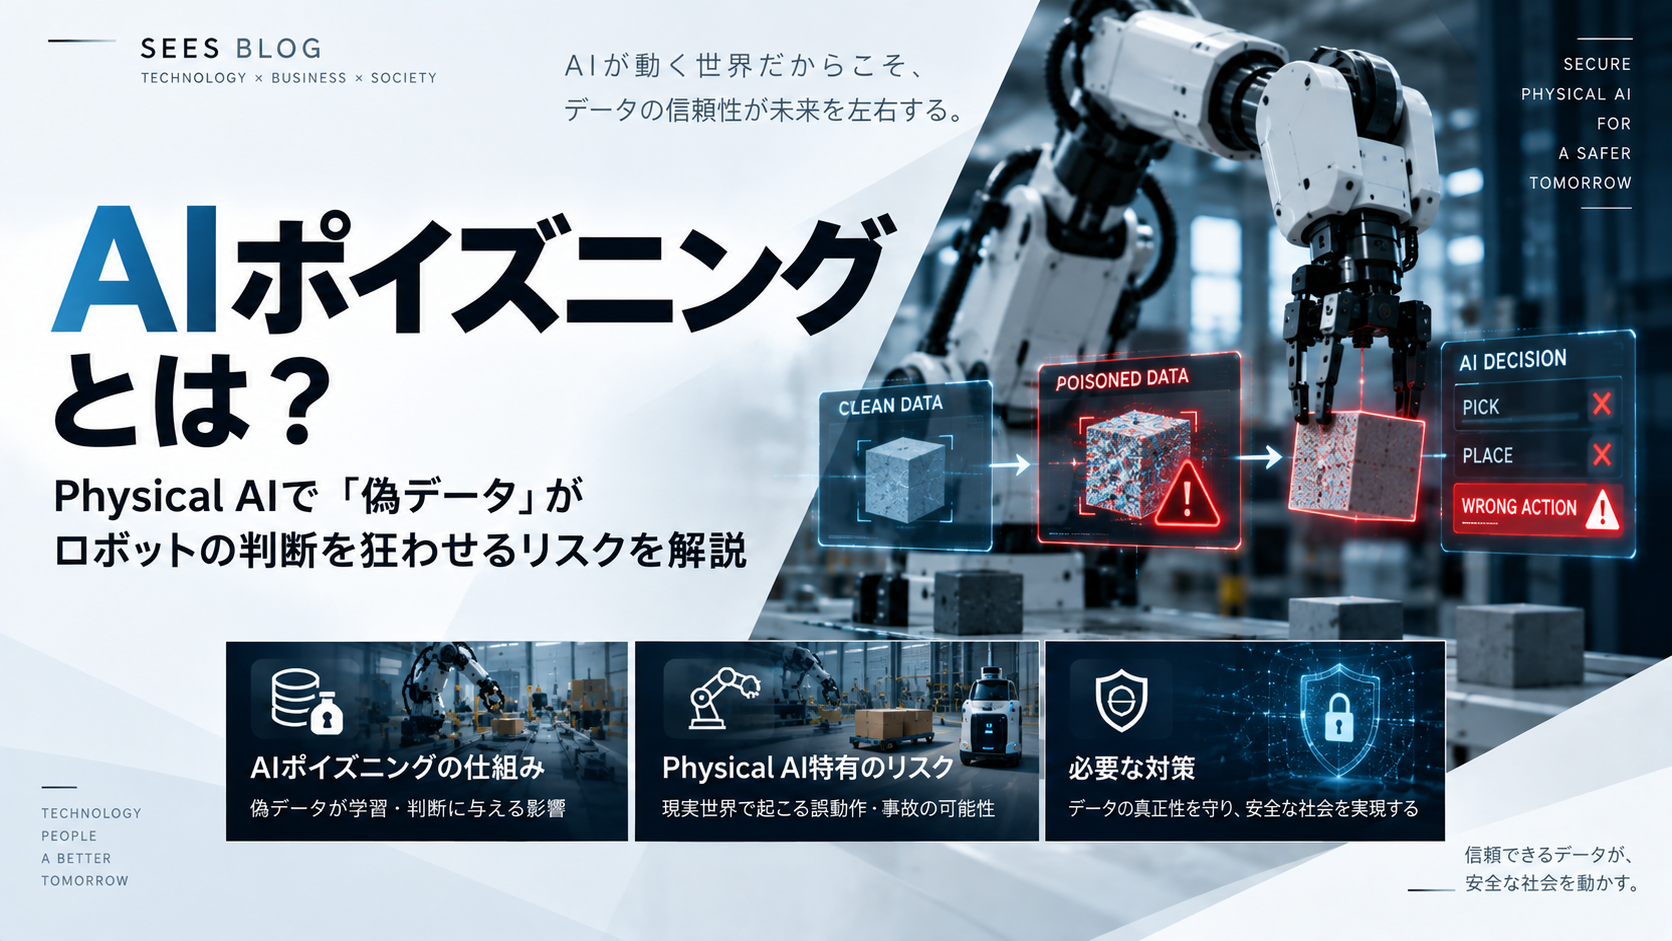
AIの普及とともに、新しいサイバーセキュリティリスクとして 注目されているのが「AIポイズニング」です。
AIポイズニングでは、AIが学習・利用するデータへ不正な情報を混入させることで、 AIの判断や出力に影響を与えます。
生成AIでも重要な問題ですが、 AIがロボット、ドローン、自動車、産業機械などを動かす Physical AI(フィジカルAI)では、 さらに重要な問題になる可能性があります。
Physical AIでは、学習データだけでなく、 AIが稼働中に利用するセンサーデータやカメラ映像などの入力データも AIの判断に影響します。 そのためAIモデルだけを保護するのではなく、 データの生成元・来歴・完全性を含むデータサプライチェーン全体 を考えることが重要です。
Physical AIではAIの判断が、 現実世界のロボットや機械の動作につながります。
さらに学習データだけではなく、 カメラ、温度センサー、LiDAR、マイク、振動センサー、 位置情報などから継続的にデータを取得します。
- AIポイズニングとは何か
- AIポイズニングとプロンプトインジェクションの違い
- Physical AIでデータ汚染が重要になる理由
- Training-Time SecurityとRuntime Data Securityの違い
- Data ProvenanceとData Integrityの重要性
- ハッシュチェーンによるデータ完全性の検証
- チップフィンガープリントとDevice Trustの関係
- Physical AI Trust Loopという考え方
- AIポイズニングとは?
- AIポイズニングはなぜ危険なのか
- AIポイズニングとプロンプトインジェクションの違い
- Physical AIでは「学習時」だけ守ればよいわけではない
- ロボットのセンサーデータが偽装されたら?
- Physical AIで考えるべき3段階のデータ汚染
- 汚染されたデータが学習され続けるリスク
- AIポイズニング対策で重要なData Provenance
- Data ProvenanceだけでなくData Integrityも必要
- AIモデルだけで対策を考えてはいけない
- ハッシュチェーンによってデータ改ざんを検証する
- チップフィンガープリントでデータ生成元を考える
- 汚染データを切り離すという考え方
- Physical AI Trust Loop
- AIが自律化するほどデータセキュリティは重要になる
- 企業がPhysical AI導入時に確認すべきポイント
- まとめ
- AIポイズニングに関するよくある質問
AIポイズニングとは?
AIポイズニングとは、 AIの学習や判断に使用されるデータを意図的に操作することで、 AIモデルの挙動や出力へ影響を与える攻撃の総称として使われます。
代表的なのが Data Poisoning(データポイズニング)です。
例えばAIの学習データへ意図的に誤ったデータを混入させることで、 次のような影響が生じる可能性があります。
- 本来Aと判断すべきものをBと判断する
- 特定の条件だけ異常な判断をする
- 特定の対象を認識しにくくする
AIは大量のデータからパターンを学習するため、 AIが何を学習するかは、与えられるデータに大きく依存します。 そのためAIセキュリティでは、 モデルそのものだけでなくデータの信頼性も重要になります。
AIポイズニングはなぜ危険なのか
従来のサイバー攻撃では、 攻撃者がシステムを直接操作するケースが多く存在しました。
AIポイズニングでは少し構造が異なります。 攻撃者がAIへ直接「右へ進め」と命令する必要はありません。
AIが学習・利用する情報そのものへ影響を与えることで、 AI自身に誤った判断をさせる ことが可能になる場合があります。
AI時代では、システムだけでなく AIが利用するデータも セキュリティの対象として考える必要があります。
AIポイズニングとプロンプトインジェクションは違う
混同されることがありますが、 AIポイズニングとプロンプトインジェクションは異なる攻撃です。
| 項目 | AIポイズニング | プロンプトインジェクション |
|---|---|---|
| 主な対象 | 学習・利用データ、モデルなど | AIへの入力・指示 |
| 攻撃方法 | データ等を汚染 | 悪意ある指示を入力 |
| 影響 | モデルの挙動・判断など | 特定の対話・処理など |
| Physical AIとの関係 | センサー・学習データ等まで拡張して考える必要 | AIエージェント等で考慮 |
特にPhysical AIでは、 一般的なLLMとは異なり、 現実世界から継続的に取得するデータ についても考える必要があります。
Physical AIでは「学習時」だけ守ればよいわけではない
一般的なData Poisoningでは、 学習段階のデータ汚染が重要な論点になります。
しかしPhysical AIでは、 学習後も現実世界から大量の情報が継続的に入ってきます。
AIが利用するセンサーデータが偽装されれば、 モデルを直接攻撃しなくても、 AIの判断へ影響を与えられる可能性があります。
例えばロボットのセンサーデータが偽装されたら?
工場内を走る自律移動ロボットを考えてみましょう。
本来、 「前方2mに人がいる」 というセンサーデータが生成されたとします。
しかし何らかの攻撃や異常によって、 「前方に人はいない」 という情報がAIへ渡された場合、 AIはそのデータをもとに判断する可能性があります。
この場合、AIモデルそのものは正常でも、 AIが判断材料として使用した入力データに問題がある可能性があります。
このためPhysical AIでは、 「AIが正しく動作しているか」だけではなく、 「AIが判断に利用しているデータを信頼できるか」 を考える必要があります。
Physical AIで考えるべき「データ汚染」は3段階ある
Physical AIでは、データの信頼性を 大きく3段階で考えると理解しやすくなります。
AIモデルを構築するために使用するデータです。 このデータが汚染されれば、 AIモデル自体の判断特性へ影響する可能性があります。
Training Data → AI Model
AIが実際に判断するときに利用するデータです。 カメラ映像、距離、位置、温度、振動、音声などが該当します。
Sensor → Runtime Data → AI Inference
Physical AIが現場データを蓄積し、 そのデータを再学習へ利用する場合に重要になります。
Field Data → Re-Training → New AI Model
現場で汚染されたデータが再学習データへ混入すれば、 Runtimeのデータ汚染がTrainingへ戻ってくる 可能性があります。
Physical AIでは「汚染されたデータが学習され続ける」可能性を考える
Physical AIの大きな特徴の一つが、 現実世界との継続的な接続です。
将来的にロボットが現場経験を再学習へ利用する場合、 次のようなLearning Loopが形成される可能性があります。
この循環はAIの能力を継続的に向上させる可能性がある一方、 新しいセキュリティ課題も生みます。
汚染されたデータがLearning Loopへ入り続ければ、 単発の誤判断だけではなく、 将来のAIモデルそのものへ影響が残る可能性 も考慮する必要があります。
AIポイズニング対策で重要な「Data Provenance」
そこで重要になるのが、 Data Provenance(データ来歴) という考え方です。
簡単に言えば、 「このデータはどこから来たのか」 を追跡できる状態を意味します。
Physical AIでは、例えば次のような情報が データ来歴を考えるうえで重要になります。
- どのロボットから生成されたか
- どのセンサーから生成されたか
- いつ生成されたか
- どの環境で生成されたか
- どのソフトウェアバージョンで処理されたか
- どの通信経路を通ったか
AIへ投入するデータの出所が分からなければ、 「このデータを学習に使ってよいのか」を 判断することが難しくなります。
Data ProvenanceだけでなくData Integrityも必要
データの出所が分かっても、 その後データが変更されていれば問題があります。
そこで必要になるのが、 Data Integrity(データ完全性)です。
Physical AIでは、 データの来歴、完全性、生成元となるデバイスの識別・認証を 組み合わせて考えることが重要になります。
AIポイズニング対策を「AIモデルだけ」で考えてはいけない
AIポイズニング対策では、 モデル監視、異常値検知、学習データ検証など、 AI側の対策が重要です。
しかしPhysical AIでは、 データがAIへ入る前から セキュリティを考える必要があります。
ハッシュチェーンによってデータ改ざんを検証する
株式会社シーズでは、 Physical AIのデータ完全性を支える技術の一つとして ハッシュチェーンを研究開発しています。
連続するデータをハッシュ値によって関連付けることで、 次のような点を検証できる仕組みです。
- 途中のデータが変更されていないか
- データの連続性が維持されているか
Physical AIではセンサーから大量の時系列データが発生するため、 AIへ届いたデータが生成後に変更されていないかを検証できる仕組み が重要になります。
チップフィンガープリントでデータ生成元を考える
データ完全性だけでは、もう一つ問題が残ります。 それは、 「そもそもどのデバイスがデータを作ったのか」 という問題です。
そこでDevice AuthenticityやDevice Identityの考え方が重要になります。
株式会社シーズでは、 半導体固有の物理特性を利用する チップフィンガープリントを研究開発しています。
これらを組み合わせることで、 データを生成したデバイスと、 生成後のデータの完全性を 一連の流れとして検証する考え方につながります。
汚染データを切り離すという考え方
Physical AIが継続的に学習する環境では、 問題が発生したデータを識別し、 学習対象から切り離すことも重要です。
定められた検証条件を満たし、 学習・分析対象として扱えるデータ。
来歴や完全性などを確認できず、 追加確認や隔離を検討すべきデータ。
疑わしいデータを識別できれば、 そのデータをそのまま再学習へ利用するリスクを 減らすことができます。
さらに、どのデータを使って、 どのAIが、どのように学習したのかを追跡できれば、 問題発生時の原因分析にもつながります。
シーズが考えるPhysical AIの「Trust Loop」
Physical AIでは、一方向のセキュリティだけでは不十分です。
シーズでは、将来的なPhysical AIにおいて、 デバイスからデータ、AI、現実世界の動作、 そして再学習までを一つの循環として捉えることが 重要になると考えています。
AIが現実世界から学習し続けるほど、 学習するデータをどこまで検証できるか という問題が重要になります。
AIが自律化するほどデータセキュリティは重要になる
AIが単なる分析ツールであれば、 最終的な意思決定を人間が確認できる場合があります。
しかしPhysical AIが高度化すると、 Sense、Decide、Actというサイクルを AIが自律的に繰り返す場面が増えていきます。
人間がすべての判断をリアルタイムに確認することが 難しいシステムでは、 AIへ入力されるデータを検証できる状態にすること が重要になります。
企業がPhysical AI導入時に確認すべきポイント
Physical AIを導入する際には、 AIモデルだけでなくデータサプライチェーンについても 確認する必要があります。
- AIが利用するデータの生成元を特定できるか
- 正規デバイスから生成されたことを確認できるか
- データの改ざんを検知できるか
- 学習データと推論データを管理できるか
- 現場データを再学習する場合、その来歴を追跡できるか
- 不審なデータを学習対象から切り離せるか
- 問題発生時に、どのデータがAIの判断へ影響したのか追跡できるか
AIモデルの管理と データサプライチェーンの管理を セットで考えることが重要です。
まとめ|Physical AI時代のAIポイズニング対策は「データの入口」から始まる
AIポイズニングは、 AIが利用するデータを操作することで、 AIの判断や挙動へ影響を与えるリスクです。
Physical AIでは、 この問題を学習データだけに限定して考えることはできません。
センサーデータ、カメラ映像、位置情報、 振動、音声、温度など、 現実世界から取得するデータもAIの判断材料になります。
さらに、それらのデータが再学習へ利用される場合には、 Runtime Data → Training Data という循環も生まれます。
株式会社シーズでは、 チップフィンガープリントによるDevice Trust、 ハッシュチェーンによるData / Transmission Trust、 スクランブルメモリによる保存データ保護、 自律分散AIセルなどを組み合わせ、 Physical AI時代のTrust Infrastructureを構築する 研究開発を進めています。
「AIは賢いか」だけではなく、 「AIは何を学び、そのデータをどこまで信頼できるのか」 という視点が重要になります。
AIポイズニングに関するよくある質問
AIポイズニングとは何ですか?
AIが学習・利用するデータなどを意図的に操作し、 AIモデルの挙動や判断へ影響を与える攻撃の総称として使われます。
データポイズニングとは何ですか?
AIの学習データなどに悪意あるデータや誤ったデータを混入させ、 モデルの判断特性などへ影響を与える攻撃です。
AIポイズニングとプロンプトインジェクションは同じですか?
同じではありません。 プロンプトインジェクションは主にAIへ悪意ある指示を入力する攻撃で、 データポイズニングは学習・利用されるデータ等を汚染する攻撃です。
Physical AIではなぜAIポイズニングが重要なのですか?
Physical AIではAIの判断が ロボットや機械の物理動作につながるためです。 また、現実世界から継続的に取得するセンサーデータについても 信頼性を考える必要があります。
Data Provenanceとは何ですか?
データがどこで、誰によって、 どのように生成・処理されたのかという 来歴を追跡する考え方です。
AIポイズニングはどう対策しますか?
学習データの検証、データ来歴管理、アクセス制御、 異常検知、データ完全性確認、モデル監視など、 複数の対策を組み合わせる必要があります。 Physical AIではさらに、 デバイスの識別・認証や通信データの完全性も重要になります。